
이미 있는 DB에서 표준단어사전 뽑아내기 — SQL 가져오기 뒤 AI에게 시킨 것
· 갱신
표준화 사업을 새로 시작하는 조직보다, 표준 없이 만들어진 시스템을 물려받은 조직이 훨씬 많습니다. 손에 있는 것은 CREATE TABLE 스크립트 20개, 컬럼명은 user_sn·aprv_stcd·last_aprv_asgn_rt 같은 약어의 연쇄, 그리고 그 약어가 무슨 단어의 약어인지 적어 둔 문서는 없습니다.
표준단어사전 만드는 법에서 “백지에서 시작하지 말고 현행 스키마에서 역추출하라”고 썼습니다. 이 글은 그 한 문장을 실제로 해 본 기록입니다. 한 사내 업무 시스템의 MySQL DDL 20테이블(속성 약 400개)을 Sqemo에 가져온 뒤, AI 코딩 에이전트에 Sqemo MCP 서버를 연결하고 아래 네 마디를 순서대로 시켰습니다. 이번에는 Claude Code를 썼지만, MCP는 표준 프로토콜이라 Codex·Gemini CLI·Cursor 등 MCP를 지원하는 에이전트면 같은 설정으로 같은 일을 합니다. 사람이 친 문장은 이 네 개가 전부이고, 나머지는 AI가 ERD를 읽고 쓴 것입니다.
- 서버에서 ERD 목록 가져와
- test import의 도메인을 추정해서 만들어줘
- 단어사전도 추정해서 만들어줘
- ERD에서 컬럼에 해당하는 도메인도 추정해서 등록해봐
(검증은 시키지 않았는데 AI가 스스로 했습니다)
아래는 각 단계에서 AI가 무엇을 했고, 어디서 사람의 결정을 요구했는지입니다. 요점은 30분이라는 시간이 아니라 그 경계선입니다. 처음 해 보는 분을 위해 준비 단계(0-1 ~ 0-3)는 화면과 명령을 그대로 적었습니다. 이미 MCP를 연결해 둔 분은 1번으로 건너뛰셔도 됩니다.
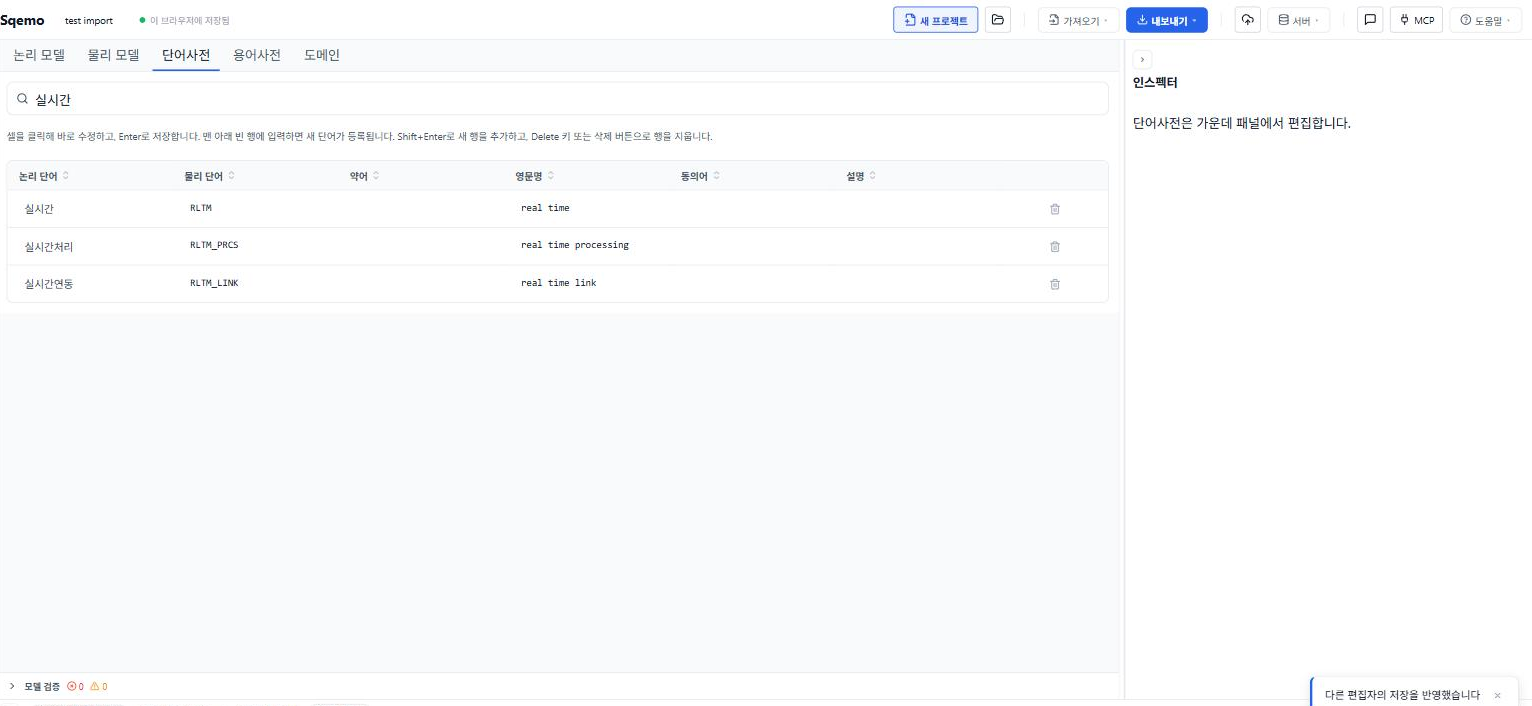
한 가지 미리 말해 두면 — 이 작업 내내 app.sqemo.com에 같은 ERD를 열어 두고 있었습니다. AI가 MCP로 저장할 때마다 브라우저 탭의 단어사전 패널과 도메인 목록이 그 자리에서 갱신됩니다(저장 안 한 편집이 없으면 자동으로 최신본으로 바뀌고 토스트가 뜹니다). 터미널에서 벌어지는 일을 화면으로 같이 보는 셈이라, AI가 무엇을 등록했는지 확인하러 새로고침할 필요가 없었습니다.
0. 준비 — 세 가지를 한 번만 해 둡니다
0-1. SQL 가져오기
app.sqemo.com을 열고 상단 가져오기 → SQL 가져오기를 누릅니다. 처음 열었을 때 뜨는 시작 화면의 “SQL 가져오기” 버튼도 같은 곳입니다. DDL 파일(.sql)을 고르거나 CREATE TABLE 문을 그대로 붙여 넣으면 됩니다. CREATE TABLE을 읽어 엔터티·속성·관계가 만들어지고, FK 제약이 없어도 _sn·_id로 끝나는 컬럼이 다른 테이블의 PK와 이름이 같으면 식별 관계를 추론합니다. 방언(MySQL·PostgreSQL·Oracle·CUBRID)은 자동으로 잡히고, 안 맞으면 가져오기 창에서 바꿀 수 있습니다.
이번 스키마는 DDL의 COMMENT에 한글 논리명이 있어서 엔터티 “사용자기본”·속성 “사용자일련번호” 같은 논리명까지 같이 채워졌습니다. COMMENT가 없는 시스템이면 논리명 채우기가 첫 수작업이 됩니다 — 아래 과정은 논리명과 물리명이 나란히 있어야 시작됩니다.
가져온 ERD는 서버에 저장해야 AI가 읽을 수 있습니다(로그인 후 저장하면 서버 ERD가 됩니다). 이름은 “test import”로 뒀습니다.
0-2. AI 에이전트에 Sqemo MCP 서버 연결
Node.js 22 이상이 필요합니다. 쓰는 에이전트에 맞춰 하나만 고르면 됩니다.
Claude Code — 프로젝트 루트에 .mcp.json 파일을 만들고:
{
  "mcpServers": {
    "sqemo": { "command": "npx", "args": ["-y", "sqemo-mcp"] }
  }
}
Codex CLI — 명령 한 줄:
codex mcp add sqemo -- npx -y sqemo-mcpCursor·Claude Desktop 등 — 각 도구의 MCP 설정 파일에 위의 mcpServers JSON을 그대로 넣습니다. 경로는 MCP 문서에 있습니다.
설정 파일을 손으로 만들기 번거로우면, 에이전트에게 https://sqemo.com/docs/mcp 주소를 주고 “이 MCP 서버 연결해 줘”라고 하는 것도 됩니다. 에이전트가 자기 설정 파일을 찾아서 씁니다.
0-3. 로그인 — 터미널에서 한 번
로컬 .erd.json 파일만 다룰 때는 로그인이 필요 없지만, 서버에 저장한 ERD를 AI가 읽고 쓰려면 한 번은 로그인해야 합니다. 터미널에서:
npx sqemo-mcp login실행하면 이렇게 묻습니다.
How do you want to sign in?
  1) Google           (opens your browser)
  2) GitHub           (opens your browser)
  3) Email + password (right here)

Choice [1]: 1
Opening your browser to sign in with google.
If it does not open, paste this URL into your browser:
  https://…/auth/v1/authorize?provider=google&redirect_to=http%3A%2F%2F127.0.0.1%3A…%2Fcallback&…
Waiting for the sign-in to complete... (Ctrl+C to cancel) ...
Logged in: you@example.com
1 또는 2를 고르면 브라우저가 열리고, 앱에 로그인할 때 쓰는 Google/GitHub 계정으로 승인하면 터미널로 돌아옵니다. 브라우저가 없는 서버라면 3번(이메일+비밀번호)이나 npx sqemo-mcp login --password를 씁니다. 저장되는 것은 갱신 토큰뿐이고(~/.erdmaker/credentials.json), 비밀번호는 저장되지 않습니다. 끝내려면 npx sqemo-mcp logout.
한 가지 주의 — 이 명령은 터미널에서 직접 쳐야 합니다. 에이전트 안에서 ! 접두어 등으로 실행하면 표준 입력이 닫혀 있어 Login failed: missing email or phone으로 실패합니다. 저도 처음에 그랬습니다.
여기까지가 준비입니다. 이제부터는 에이전트에게 말만 하면 됩니다.
1. “서버에서 ERD 목록 가져와”
로그인 전에 이 말을 먼저 했더니 이렇게 돌아왔습니다.
not_authenticated: Login required. Run `npx sqemo-mcp login` in a terminal0-3을 하고 같은 말을 다시 하니 ERD 6개가 표로 돌아왔습니다 — 이름·소유자/편집자 역할·공유 여부·최종 수정 시각. “test import”가 맨 위에 있었습니다.
| 이름 | 역할 | 공유 | 최종 수정 |
|---|---|---|---|
| test import | owner | – | 방금 |
| Online Shop Example | owner | ✓ | 3시간 전 |
| … |
이 단계에서 AI가 한 일은 list_erds 도구를 한 번 부른 것뿐입니다. 하지만 이 한 번으로 이후 모든 요청이 “그 ERD”를 가리킬 수 있게 됩니다. 파일을 첨부하거나 스키마를 붙여 넣을 일이 없습니다.
2. “test import의 도메인을 추정해서 만들어줘”
AI는 먼저 ERD 개요를 읽었습니다 — 엔터티 20, 관계 17, 도메인 0, 단어 0. 그리고 엔터티 20개의 속성 전체(약 400개)를 가져와 속성명의 마지막 낱말(분류어) 과 데이터 타입을 짝지어 셌습니다. 도메인은 “같은 성격의 속성은 같은 타입”이라는 규칙이니, 역추출은 이 집계에서 시작합니다.
| 분류어 | 타입 | 예 |
|---|---|---|
| 일련번호 | BIGINT | user_sn, group_sn, menu_sn |
| 여부 | CHAR(1) | del_yn, use_yn, eml_noti_yn |
| 코드 | VARCHAR(4) | user_tpcd, aprv_stcd, ctrt_secd |
| 일시 | DATETIME | reg_dt, mdfcn_dt, last_cntn_dt |
| 일자 | VARCHAR(8) | use_term_ymd, stpl_ymd |
| 명 | VARCHAR(200) | user_nm, inst_eng_nm, pic_nm |
| 금액 | BIGINT | ctrt_bgt_kcur_amt, rtrvl_usd_amt |
| 비율 | NUMERIC(12,3) | last_aprv_asgn_rt |
| 환율 | NUMERIC(9,4) | aplcn_usd_exchrt |
이 집계를 바탕으로 AI가 upsert_domain으로 도메인 28개를 등록했습니다. 사람이 표를 옮겨 적은 자리는 없습니다.
그리고 등록하지 않은 것을 따로 돌려줬는데, 그 목록이 이 단계의 진짜 산출물입니다. 분류어는 같은데 타입이 갈라진 경우들입니다.
명은 대부분VARCHAR(200)인데그룹명·기관명·내역계약영문명3개만VARCHAR(500). AI는명(200)과장문명(500)으로 나눴습니다. 기관명이 정말 500자가 필요한 것인지 누군가 넉넉히 잡은 것인지는 스키마가 답해 주지 않으니, 사람이 봐야 합니다.설명은VARCHAR(300)이 다수인데그룹설명만 2000,계약한글설명은 4000. 4000은내용도메인과 같으니 그쪽으로, 2000은 예외로 남겼습니다.코드는VARCHAR(4)가 표준이지만기관코드는 5자리,국가코드는 ISO 2자리. 이건 예외가 아니라 별개 도메인입니다. 기관코드 체계와 국가코드 체계는 다른 것이니까요.
역추출이 주는 것은 “지금 이렇게 쓰고 있다”는 사실이고, 그중 무엇이 표준이고 무엇이 실수인지는 통계가 아니라 업무가 정합니다. AI는 다수를 표준으로 잡고 소수를 예외로 돌려줬고, 예외 3건의 판단은 사람 몫으로 남았습니다.
3. “단어사전도 추정해서 만들어줘”
도메인이 분류어 하나를 보는 일이라면, 단어사전은 논리명 전체를 낱말 단위로 쪼개 물리명의 토큰과 정렬하는 일입니다.
계약 | 실시  | 기관  | 영문 | 명
ctrt | enfrc | inst | eng | nm
AI는 이미 읽어 둔 400개 속성으로 이 정렬을 해서 낱말 약 200개를 뽑고, upsert_dictionary_word로 204개를 등록했습니다 — 논리 단어, 물리 약어, 영문명(사용자→user→user, 권한→authrt→authority, 배정→asgn→assignment, 협력→clbr→collaboration). 이번 스키마는 공공 표준단어를 따라 만든 것이라 같은 낱말이 항상 같은 약어로 나왔고, 그래서 한 번에 됐습니다. 표준 없이 만들어진 시스템이라면 여기서 NUM·NBR·NO가 나란히 나오고, 그 목록이 동의어 정리의 재료가 됩니다.
한 가지 부수 사항으로, 이때는 AI가 단어를 하나씩 등록하는 도구를 204번 불렀고, 단건 등록 하나가 서버 호출 네 번(읽기·권한 확인·쓰기·알림)이라 MCP의 분당 요청 상한(120건)에 걸려 일부가 거부됐습니다. 등록이 논리 단어 기준 upsert라 거부된 것만 다시 보내면 되고 중복은 생기지 않았지만, 이 글을 쓰면서 여러 단어를 한 번의 저장으로 넣는 upsert_dictionary_words·upsert_domains(2.7.0), 그리고 아래 4번을 위한 upsert_attributes(2.8.0)를 추가했습니다. 지금 같은 작업을 시키면 204개가 호출 한 번으로 끝나고, 이 글의 역추출 세 단계 전체가 호출 세 번입니다.
정렬이 잘 된 스키마에서도 결정 지점 세 개가 있었고, AI가 각각 어떻게 처리했는지 보고했습니다.
하나. 같은 낱말이 위치에 따라 다른 약어인 경우. “내역”은 테이블명 끝(tc_user_add_authrt_dept_ls)에서는 ls, 속성명 안(dsctn_ctrt_korn_nm, 내역계약한글명)에서는 dsctn입니다. “이력”도 테이블에서는 hs, 속성에서는 hstry. 단어사전은 한 낱말에 약어 하나이므로 둘 중 하나를 골라야 했고, AI는 엔터티 쪽(ls)을 대표로 등록하고 “내역계약”을 dsctn_ctrt 복합어로 따로 넣었습니다. 이 시스템의 관례를 사전에 옮긴 것이지 정답은 아닙니다. 새 시스템이라면 처음부터 하나로 통일하는 편이 낫습니다.
둘. 두 낱말이 한 약어로 굳은 경우. “유형코드”는 tp_cd가 아니라 tpcd, “상태코드”는 stcd, “구분코드”는 secd. 공공 표준단어의 오래된 관용이고, “유형코드→tpcd” 복합어로 넣어야 물리명 생성이 실제 컬럼과 맞아떨어집니다. 생성 규칙의 일관성보다 현장 표기와의 일치가 우선이라는 원칙이 그대로 적용된 자리입니다.
셋. 논리명이 없는 컬럼. 400개 중 13개는 COMMENT가 없어 논리명이 물리명 그대로였습니다 — last_pwd_chng_dt, tmp_pwd_yn, sp_nd_yn 같은, 나중에 추가된 것으로 보이는 컬럼들입니다. 이 13개는 사전이 풀어 주지 못합니다. sp_nd가 무엇의 약어인지는 만든 사람만 압니다. 역추출은 문서화된 것을 구조화해 줄 뿐, 문서화되지 않은 것을 만들어 내지는 못합니다. AI는 이 13개를 목록으로 돌려주고 “한글 논리명을 붙이려면 알려 달라”고 했습니다.
4. “ERD에서 컬럼에 해당하는 도메인도 추정해서 등록해봐”
도메인을 만들어 둔 것과 속성이 그 도메인을 쓰고 있는 것은 다릅니다. 연결이 돼야 도메인 타입을 바꿨을 때 속성 400개가 따라오고, 새 속성에 “여부”라고 적으면 CHAR(1)이 자동으로 붙습니다. 그래서 마지막으로 속성 하나하나를 도메인에 연결하게 했습니다.
AI가 세운 규칙은 두 줄입니다. 도메인명이 논리명의 접미어이고, 데이터 타입이 도메인과 정확히 같을 때만 연결한다. 두 번째 조건이 중요한데, Sqemo에서 속성에 도메인을 붙이면 타입이 도메인 것으로 바뀝니다. 그룹명 VARCHAR(500)에 명(VARCHAR(200))을 붙이면 컬럼이 200자로 줄어드는 것이고, 그건 역추출이 아니라 스키마 변경입니다. 타입이 다른 것은 연결하지 않고 목록으로 돌려주는 것이 맞습니다.
결과는 속성 407개 중 378개 연결이었습니다.
| 연결 | 건수 | 비고 |
|---|---|---|
| 접미어·타입 일치 | 373 | 여부 65, 코드 53, 일시 43, ID 41, 명 36, 일련번호 29, 금액 15, 일자 15 … |
| 접미어의 변형 도메인으로 연결 | 5 | 그룹명·기관명·내역계약영문명(VARCHAR 500) → 장문명. 2번에서 나눠 둔 도메인이 여기서 쓰였습니다 |
| 타입 불일치로 미연결 | 16 | 계약한글설명 4000 vs 설명 300, 인증서DN값 300 vs 값 100, 기관코드 5자리 체계와 다른 11자리 외부 코드 등 |
| 논리명 없음 | 13 | 3번의 그 13개 — 접미어를 읽을 수 없으니 여기서도 빠집니다 |
미연결 16건이 이 단계의 산출물입니다. 계약한글설명은 설명이 아니라 내용 도메인에 붙이는 게 맞는지, 11자리 외부 기관코드는 별개 도메인으로 만들지 — 도메인 단계에서 남겨 둔 결정 3건이 속성 단계에서 16건의 실물로 나타난 것입니다. 하나 걸러낼 것도 있었습니다. 부서팩스번호가 접미어 “번호”의 변형인 전화번호(VARCHAR 256)에 붙었는데, 타입은 같지만 팩스를 전화번호 도메인으로 볼지는 사람이 정할 일입니다.
이때 브라우저 탭을 보고 있으면 속성 옆에 도메인명이 하나씩 채워지는 것이 보입니다. 이 작업은 속성 단위 호출이라 378번 저장이 일어났고 10분쯤 걸렸는데(단건 도구는 호출마다 프로젝트를 읽고 씁니다), 그래서 벌크 도구 upsert_attributes를 만든 것입니다. 지금은 378건이 저장 한 번입니다.
5. 검증 — 사전이 실제 컬럼명을 다시 만들어 내는가
사전과 도메인이 맞는지 확인하는 방법은 하나입니다. 논리명에서 물리명을 생성했을 때 실제 컬럼명과 같은가. 시키지 않았는데 AI가 이 검사(check_naming)를 스스로 돌렸고, 첫 결과는 불일치였습니다.
최종승인배정비율 → LAST_APRV_ASGN_RT (실제: last_aprv_asgn_rt)낱말 분해는 정확한데 대소문자가 달랐습니다. 명명 규칙이 기본값(대문자)이었기 때문입니다. AI가 규칙을 이 시스템에 맞게 소문자·_ 구분·자기참조 접두사 “상위”(up)로 바꾸고 다시 검사했습니다.
| 논리명 | 사전이 생성한 물리명 | 실제 컬럼 | 일치 |
|---|---|---|---|
| 최종승인배정비율 | last_aprv_asgn_rt | last_aprv_asgn_rt | ✅ |
| 계약실시기관영문명 | ctrt_enfrc_inst_eng_nm | ctrt_enfrc_inst_eng_nm | ✅ |
| 상위메뉴일련번호 | up_menu_sn | up_menu_sn | ✅ |
| 사용자추가권한부서내역 | user_add_authrt_dept_ls | tc_user_add_authrt_dept_ls | 접두사만 다름 |
마지막 줄이 남은 결정 하나입니다. 테이블명 접두사 tc_(공통)·tb_(업무)은 주제영역 표시인데, 단어사전은 낱말을 다루지 주제영역을 다루지 않으니 사전으로는 표현할 수 없습니다. 이건 명명 규칙 쪽 항목이고, 명명 규칙 글에서 다룬 “접두사를 쓸 것인가”의 문제가 여기서 실물로 나타난 셈입니다.
검증이 통과한다는 것의 의미는 명확합니다. 이제 이 시스템에 새 테이블을 추가할 때 논리명만 적으면 기존 400개와 같은 규칙으로 물리명이 나오고, 사전에 없는 낱말을 쓰면 그 자리에서 경고가 뜹니다. 역추출한 표준이 문서가 아니라 규칙으로 작동하기 시작하는 지점입니다.
자동으로 된 것과 사람이 한 것
| AI가 한 것 | 사람이 할 것 |
|---|---|
| ERD 목록·개요·속성 400개 읽기 | 로그인 한 번 |
| 분류어·타입 집계 → 도메인 28개 등록 | 타입이 갈라진 3건: 예외인지 별개 도메인인지 |
| 논리명–물리명 토큰 정렬 → 단어 204개 등록 | 위치별 약어 충돌 2건: 대표어가 맞는지 |
복합어(tpcd 등) 식별 | 논리명 없는 13개 컬럼의 뜻 복원 |
| 속성 407개 중 378개를 도메인에 연결 | 타입이 다른 16개: 도메인을 바꿀지 예외로 둘지 (+ 팩스번호 1건 검토) |
| 명명 규칙 맞추고 생성값–실제값 대조 | 테이블 접두사 규칙 결정 |
사람이 친 문장은 네 마디, 남은 결정은 도메인 3·약어 2·미연결 16·논리명 13 — 전부 목록으로 받았습니다. 400개를 읽고 표로 만드는 일은 AI가 했고, 그 표에서 튀어나온 예외를 보고 “이건 표준, 이건 실수, 이건 별개”를 가르는 일이 사람 몫으로 남았습니다. 표준화 작업에서 시간을 잡아먹는 쪽은 전자였고, 가치가 있는 쪽은 후자입니다. 순서가 바뀐 것이 이번 작업에서 가장 달라진 점입니다.
해 보려면
Sqemo에서 SQL 가져오기와 단어사전·도메인·명명 규칙은 무료이고 가입 없이 로컬 파일로 쓸 수 있습니다. AI에게 시키는 부분은 MCP 서버(npx sqemo-mcp)를 쓰는 에이전트에 연결하면 되는데 — Claude Code, Codex, Gemini CLI, Cursor 등 MCP를 지원하면 어느 것이든 됩니다 — 서버 ERD를 읽고 쓰는 도구라 이 부분만 로그인이 필요합니다. MCP 없이 하려면 가져온 ERD에서 속성을 CSV로 내보내 AI에게 붙여 넣고, 돌아온 단어 목록을 단어사전 CSV(logicalWord, physicalWord, englishName …)로 다시 가져오는 경로도 같은 결과를 냅니다 — 다만 검증 단계를 사람이 돌려야 합니다.
한 가지만 덧붙이면 — 역추출의 결과물은 사전이 아니라 예외 목록입니다. 204개 단어가 등록됐다는 사실보다, 타입이 갈라진 3건과 약어가 갈라진 2건과 도메인에 못 붙은 16건과 뜻을 모르는 13건이 무엇인지가 그 시스템에 대해 더 많은 것을 말해 줍니다. 그 목록을 손에 쥐고 시작하는 표준화와, 빈 시트에서 시작하는 표준화는 다른 작업입니다.